
Labelfree 非标记定量蛋白组学概述
通过使用稳定同位素标记可以使蛋白定量结果准确稳定,然而也有其自身限制,比如额外的样本处理标记步骤、高昂的试剂成本、标记效率问题、低丰度肽段损失以及样本检测通量受限等。采用非标记蛋白定量(Labelfree)可以避免这些问题的烦恼。[1]
Labelfree 是通过比较质谱分析次数或质谱峰强度,分析不同来源样本蛋白的数量变化,利用相关统计软件(MaxQuant / Proteome Discoverer)对蛋白质进行定量。每个样本独立运行 LC-MS/MS,无需化学标记试剂,样本数量不受通道数限制,目前已经成为蛋白质组学领域内较为快速和经济高效的解决方案。[2]
Labelfree 定量支持 DDA(数据依赖采集)和 DIA(数据非依赖采集)两种模式。DDA 适合发现型研究,DIA 覆盖更全面、重复性更好。结合 MaxQuant 的 match between runs 功能,可以跨运行对齐定量信号,最大限度减少 missing values。[3]
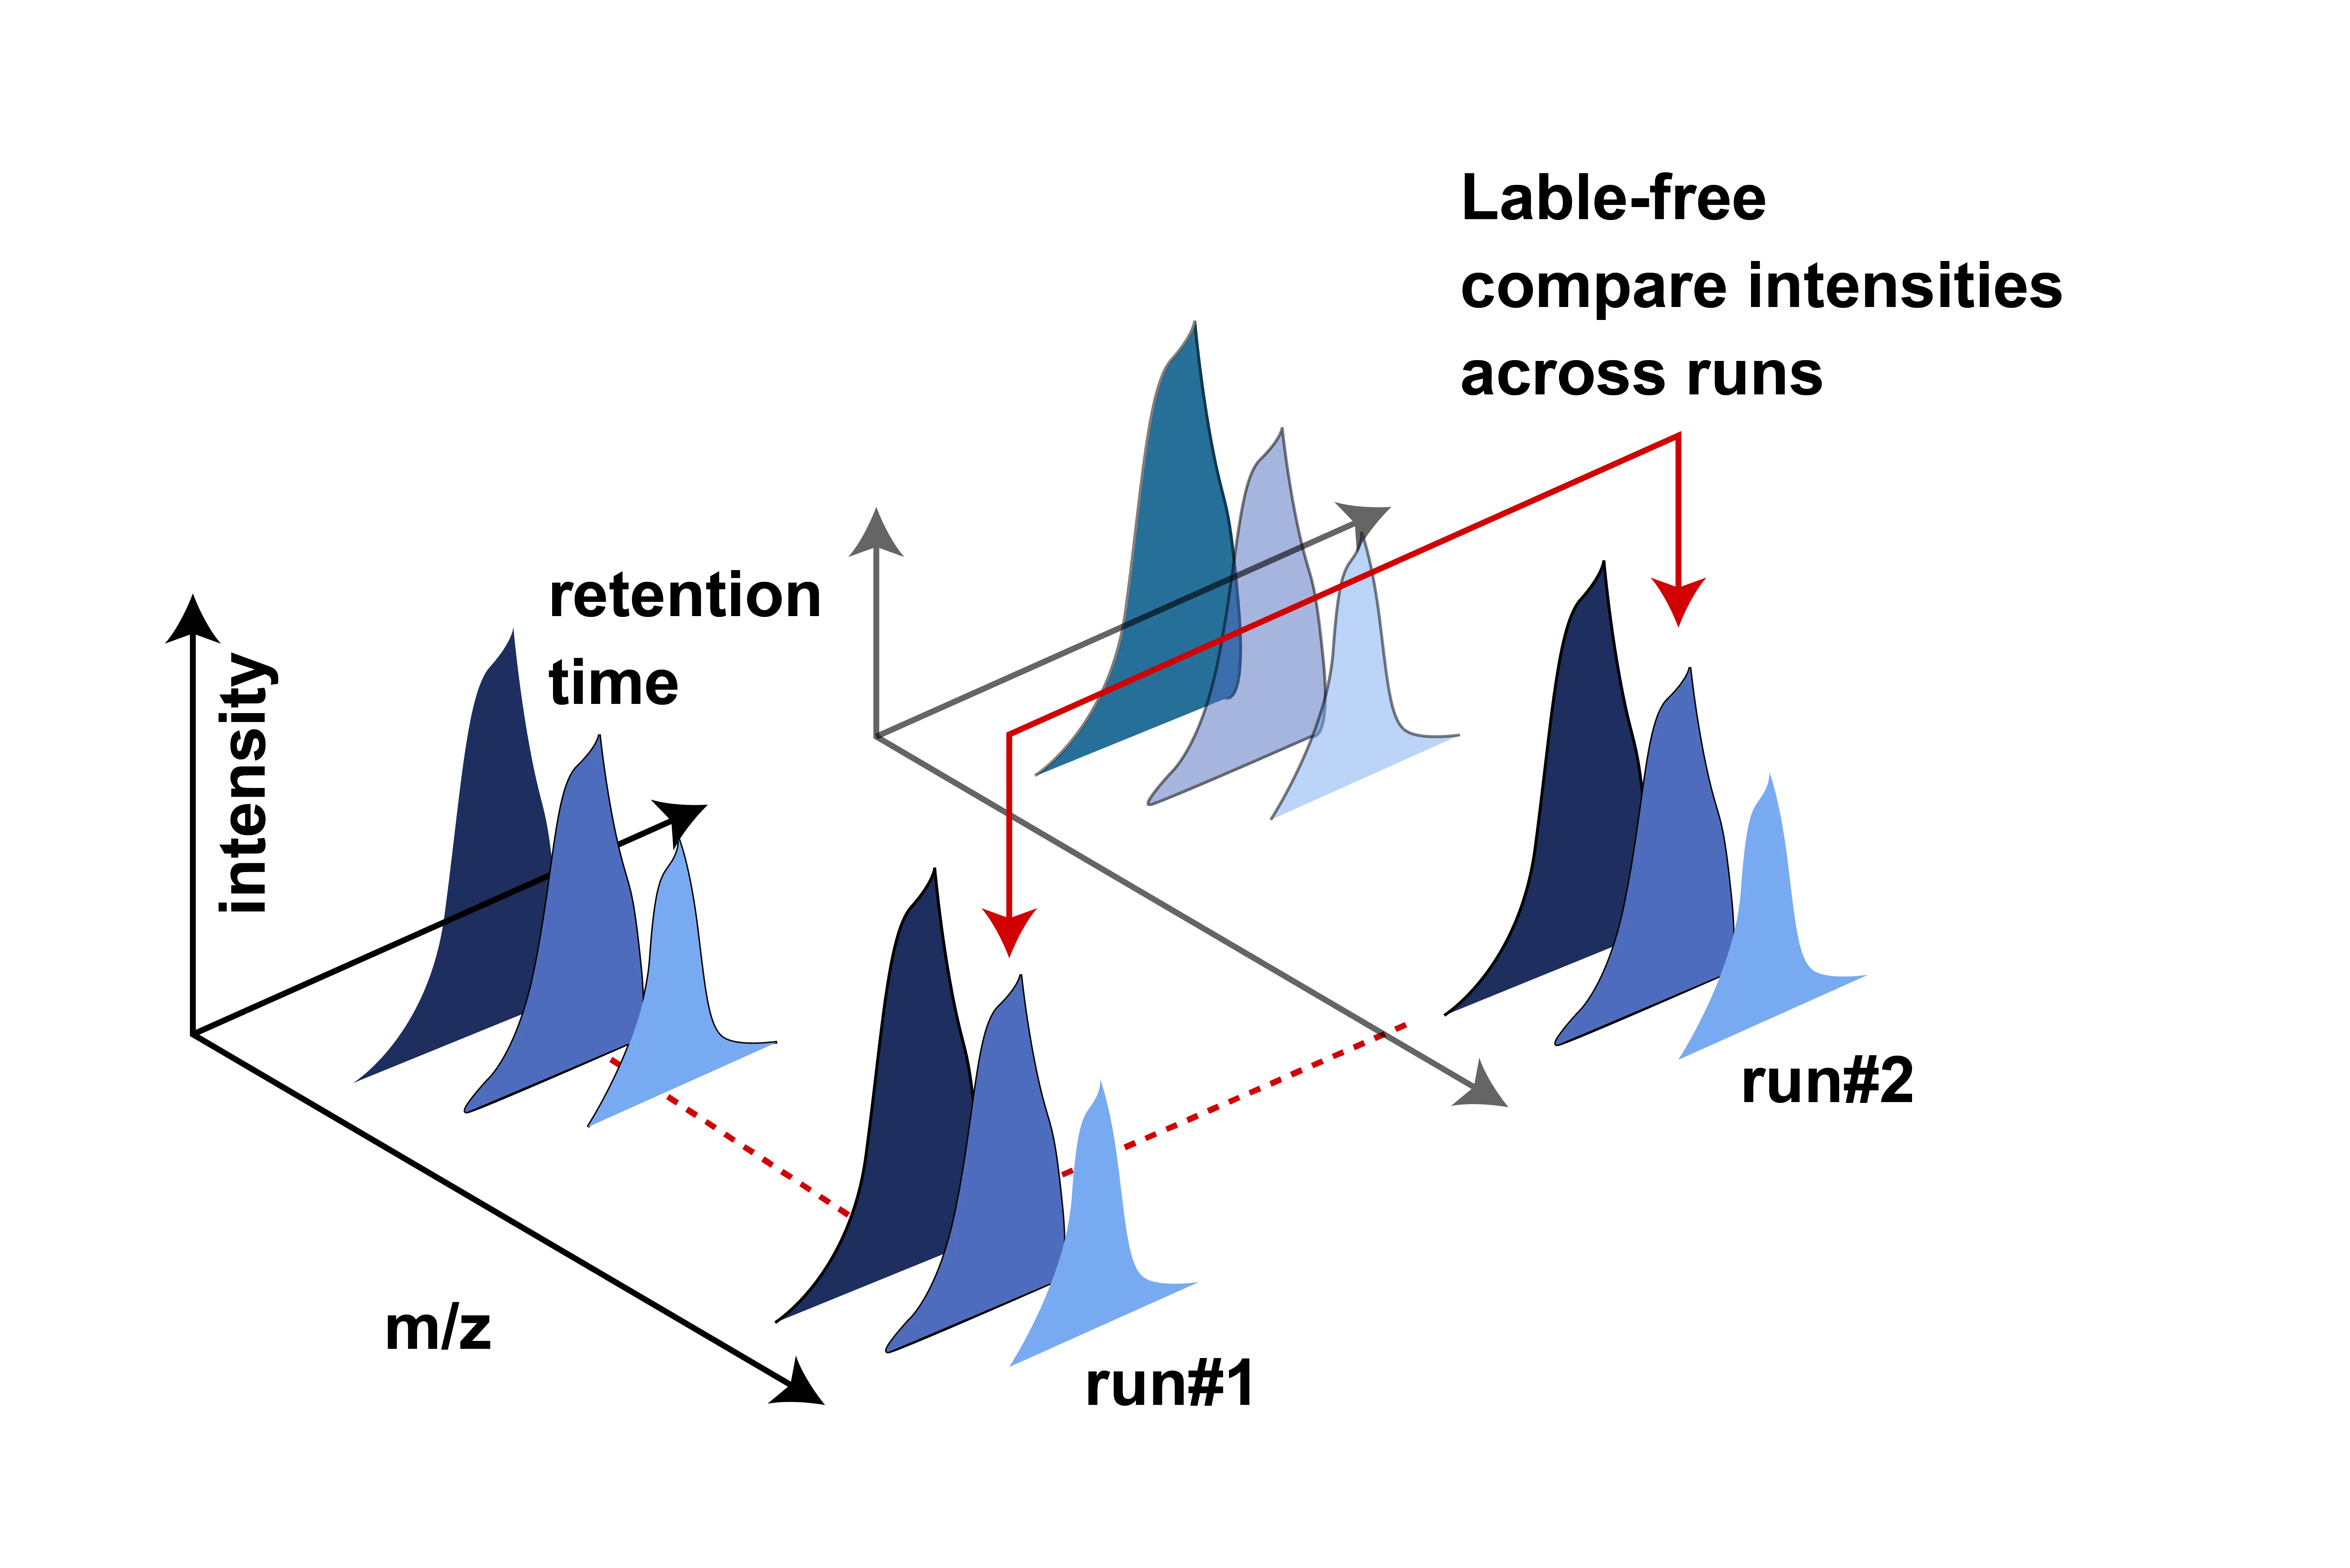
Labelfree 非标记定量的研究价值
Labelfree 非标记定量技术突破了标记试剂的通道数限制,在超大样本队列研究、临床样本分析和预算敏感项目中具有不可替代的优势。
超大样本队列研究
当样本数量远超 iTRAQ(8 标)或 TMT(16 标)的通道数限制时,Labelfree 是唯一可行的定量方案。在流行病学研究、多中心临床试验和大规模药物筛选中,Labelfree 可处理数十到数百个样本的定量比较,无通道上限。[4]
特殊样本类型分析
某些样本类型不适合化学标记,如临床 FFPE 组织切片(标记效率低)、稀有微量样本(标记损失大)、特殊体液(脑脊液、眼泪等蛋白含量极低)。Labelfree 直接分析无需标记,最大限度减少样本损失。
经济高效的发现型研究
在预算有限但需要全面覆盖蛋白组的探索性研究中,Labelfree 省去了昂贵的标记试剂成本(iTRAQ/TMT 试剂每套数千元),将预算集中在更多生物学重复和更深的质谱覆盖上。
DDA vs DIA 采集模式
Labelfree 定量支持两种质谱采集模式,选择哪种取决于研究目的和样本规模:
DDA 数据依赖采集
发现型 Top-N 经典方案选择信号强度排名前 N 的母离子进行 MS2 碎裂鉴定。优势是鉴定深度高、数据分析流程成熟(MaxQuant 原生支持);缺点是低丰度肽段可能被遗漏,跨运行重复性稍差。
适用场景:发现型研究、小样本量(<20 个)深度鉴定、需要最大化蛋白覆盖的初探实验。
DIA 数据非依赖采集
全覆盖 SWATH 高重复性将全质量范围划分为固定窗口,每个窗口内所有母离子同时碎裂。优势是覆盖全面、重复性极好(CV < 10%)、可重分析性高;缺点是需要谱图库或 library-free 算法(DIA-NN)解析。
适用场景:大样本队列(>20 个)、需要高重复性的纵向研究、需要后续反复挖掘数据的项目。
Aimsmass 检测流程
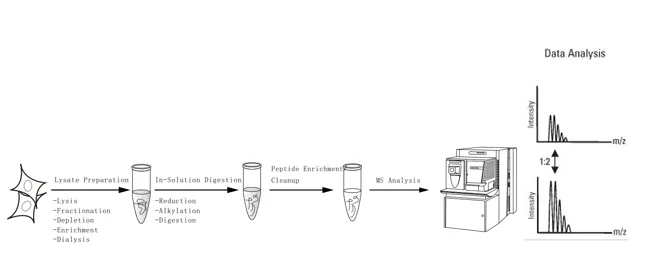
Aimsmass 基于专业的 Thermo Fisher LC-MS/MS 质谱平台,提供高效、可靠的 Labelfree 定量蛋白组学服务。标准检测流程如下:
Labelfree 标准检测流程
样本前处理:适配细胞、组织、血清、微生物等多种样本类型,采用质谱兼容体系完成蛋白提取、还原烷基化、胰蛋白酶完整酶解,确保肽段质量。
LC-MS/MS 独立采集:每个样本独立运行纳流反相色谱-串联质谱分析。DDA 模式选择 Top-N 母离子碎裂,DIA 模式全窗口采集。随机化上机顺序以消除系统偏差,间隔插入 QC 质控样本监控仪器稳定性。
信号对齐与定量:使用 MaxQuant(DDA)或 Spectronaut/DIA-NN(DIA)进行跨运行信号对齐和定量。DDA 模式通过 match between runs 减少 missing values,DIA 模式通过谱图库匹配实现全面定量。
统计分析与功能注释:执行严格的统计质控,输出差异蛋白列表及全套可视化图表(火山图、热图、GO/KEGG 注释、PPI 网络等)。
Labelfree vs iTRAQ/TMT vs DIA 对比
| 对比维度 | Labelfree (DDA) | iTRAQ / TMT | DIA |
|---|---|---|---|
| 标记方式 | 无标记 | 等重标记(4-18-plex) | 无标记 |
| 样本量限制 | 无上限 | ≤18 个/批 | 无上限 |
| 标记成本 | 无标记试剂,最低 | 较高(试剂昂贵) | 无标记试剂,最低 |
| 批次效应 | 需严格质控 | 标记后混合,最低 | 较低(窗口固定) |
| 定量 CV | 15-20% | < 15% | < 10% |
| 鉴定深度 | 4000-6000 蛋白 | 5000-10000 蛋白 | 5000-8000 蛋白 |
| 可重分析性 | 需重新采集 | 需重新标记 | 原始数据可反复挖掘 |
| 数据分析 | MaxQuant (成熟) | MaxQuant/PD (成熟) | 需专门软件 (DIA-NN 等) |
| 推荐场景 | 超大队列 / 预算敏感 | 中小规模精确定量 | 大样本高重复性 |
数据分析
Labelfree 定量蛋白组学数据分析涵盖统计分析、功能注释分析和蛋白聚类与互作分析三大板块,全面展示蛋白表达差异和生物学功能信息。
统计分析
| 统计分析 | 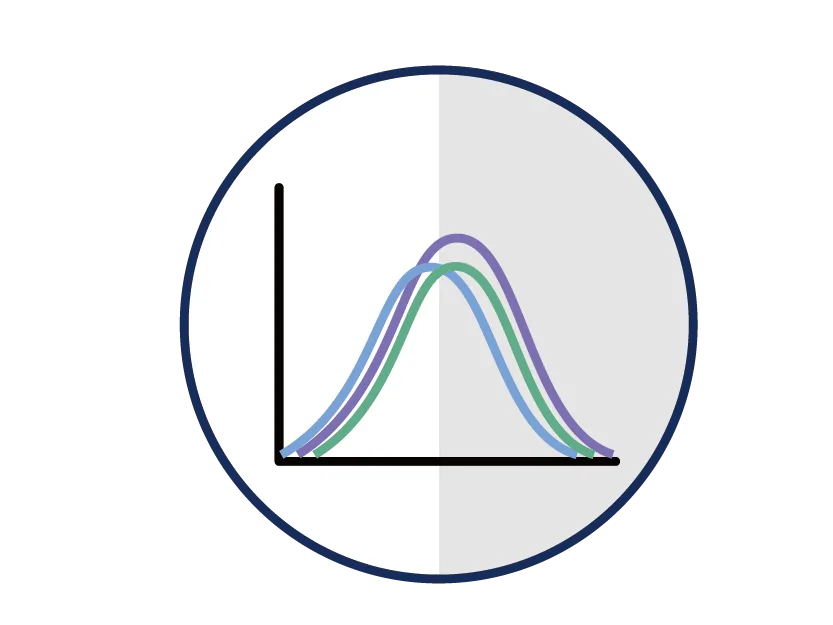 |
全局统计分析所有鉴定到蛋白表达量的分布范围,每条曲线表示一个样本,分布是经过正态分布拟合处理后的,图中纵坐标为频数,横坐标为表达量 log10 后的数值。 |
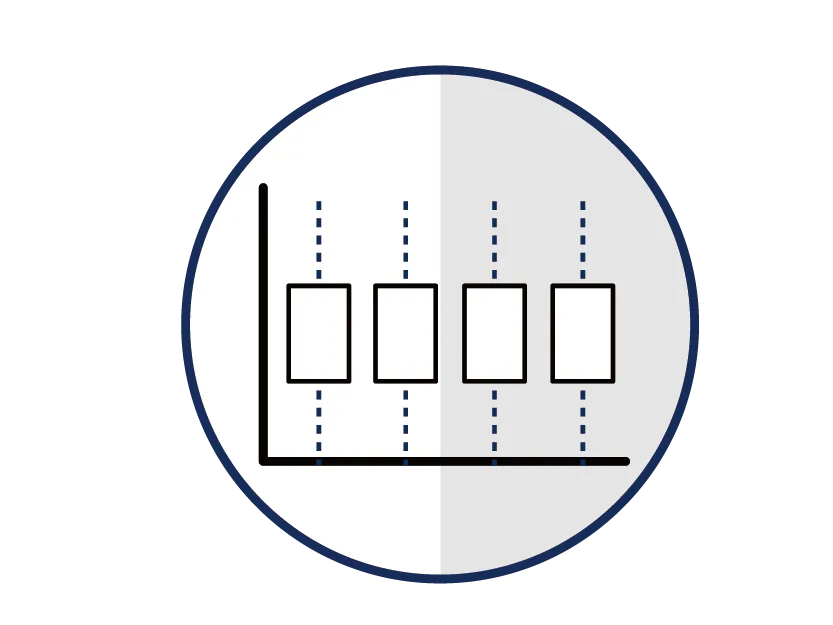 |
箱式图箱式图又称盒须图、盒式图或者箱线图,是一种表现有关数据的位置和分散情况资料的统计图。箱型图主要包含六个数据节点,可粗略表达出数据是否有对称性、分散程度等信息。 | |
 |
PCA 分析主成分分析(PCA 分析)是数理统计中的一种降维分析方法,将一组数据的主要矛盾提取出来,提取出的核心要素成为"成分"(component),并以百分比排序。排名靠前的主成分可以反应复杂数据中的关键信息。 | |
 |
火山图火山图(Volcano Plot)在一张图中显示了两个重要指标(Fold Change / p-Value),可以非常直观且合理地筛选出在样本之间发生差异表达的蛋白。 |
功能注释分析
| 功能注释 |  |
GO 注释基因的本体论(Gene Ontology)是建立一套特定的词汇集合来描述生物学功能,以此对基因功能注释统一化。用于描述生物学功能的词汇反映生物学功能的本质。 |
 |
KEGG 分析京都基因与基因组百科全书(KEGG)是基因组破译方面的数据库,整合了基因组、化学和系统功能信息的数据库,用于揭示差异蛋白参与的信号通路和代谢途径。 |
蛋白聚类与互作分析
| 聚类与互作 |  |
聚类热图聚类热图(heatmap)是通过排列矩阵的行列,将相似的数值放在一起展示聚类分析结果的图像,以直观呈现多样本多个蛋白的全局表达量变化,呈现多样本或多蛋白表达量的聚类关系。 |
 |
蛋白互作图蛋白互作图(PPI)预测蛋白之间相互作用的示意图,每一个圆形表示蛋白质,球之间的线条表示蛋白之间的相互关系。蛋白作为细胞功能执行者,不是凭借单个蛋白独立执行,而是依靠蛋白之间相互作用执行功能。 |
数据交付内容
蛋白定量总表
包含蛋白名称、蛋白编号、各样本定量值(LFQ intensity)、组间差异倍数和统计显著性。
差异蛋白筛选结果
火山图、热图等差异分析图表,按 Fold Change 和 p-Value 双重阈值筛选的差异蛋白列表。
原始质谱数据
全部 LC-MS/MS 原始数据文件(.raw),支持后续独立分析与回溯挖掘。
功能注释与可视化图表
GO 注释、KEGG 通路富集、蛋白互作网络分析、聚类热图等可直接用于论文投稿的可视化图表。
送样要求
| 样本类型 | 送样量/每个样本 |
|---|---|
| 细胞系 | 1×10⁷ 个 |
| 动物组织(鸡肉/器官) | 50mg |
| 动物组织(骨骼/软骨) | 500mg |
| 植物组织(叶片/花) | 200mg |
| 植物组织(种子/根茎) | 5g |
| 血清/体液 | 500μL |
| 酵母/微生物 | 300-400mg |
| 蛋白溶液 | DDA ≥ 50μg,DIA ≥ 100μg |
* 具体的样本制备和保存要求请参考送样指南,或联系技术支持获取定制化送样方案。样本需 -80°C 保存,干冰运输。建议生物学重复至少 3 个(DIA 可降至 2 个)。
检测平台:Thermo Fisher Orbitrap Exploris 480 / Q Exactive HF-X 高分辨质谱仪(分辨率 240,000 @ m/z 200,扫描速度 40 Hz),搭配 EASY-nLC 1200 纳升液相色谱系统 + HPLC-MS/MS
开启您的 Labelfree 定量蛋白组学研究
提交咨询,Aimsmass 技术团队将根据您的课题定制 Labelfree 实验方案和报价。
获取定制方案与报价 查看全部定量蛋白组学服务相关蛋白质组学服务
参考文献
- Tian X, et al. Chemical isotope labeling for quantitative proteomics. Mass Spectrom Rev. 2021;42(2):546-576. DOI:10.1002/mas.21709 方法学,定量
- Sivanich MK, et al. Recent advances in isobaric labeling and applications in quantitative proteomics. PROTEOMICS. 2022;22(19-20):2100256. DOI:10.1002/pmic.202100256 综述,TMT
- Louca S, et al. Advances in data-independent acquisition mass spectrometry towards comprehensive digital proteome landscape. Mass Spectrom Rev. 2023;42(6):2324-2348. DOI:10.1002/mas.21781 DIA
- Li J, et al. Data-independent acquisition (DIA): an emerging proteomics technology for analysis of drug-metabolizing enzymes. Drug Discov Today Technol. 2021;39:49-56. DOI:10.1016/j.ddtec.2021.06.006 综述
常见问题
Labelfree 与 iTRAQ/TMT 有什么区别?
Labelfree 无需化学标记试剂,直接比较不同 LC-MS/MS 运行中肽段的信号强度。优势是不受标记通道数限制,可比较任意数量样本;成本更低,无标记试剂费用。缺点是需要更严格的实验重复性控制,批次效应较标记方法(iTRAQ/TMT)略高。
DDA 和 DIA 采集模式有什么区别?
DDA(数据依赖采集)选择 top-N 强度母离子碎裂,适合发现型研究,数据分析流程成熟。DIA(数据非依赖采集)对所有母离子窗口式碎裂,覆盖更全面,重复性更好(CV < 10%),适合大样本队列。DIA 数据分析需要专门的谱图库或 library-free 算法(如 DIA-NN)。如需更详细的 DIA 方案说明,请参考 DIA 定量蛋白组学专题页面。
Labelfree 适用于什么场景?
适用于:样本数量超过 iTRAQ/TMT 通道限制的情况;临床样本(无法统一标记);稀有样本(标记损失大);预算有限的大规模筛选研究;需要后续重分析的项目(尤其 DIA 模式)。当样本数 ≤8 组且追求精度时,推荐 iTRAQ;≤16 组推荐 TMT。
送样要求是什么?
蛋白总量 ≥ 50μg/样本(DDA)或 ≥ 100μg/样本(DIA),浓度 ≥ 0.5μg/μL。建议生物学重复至少 3 个(DIA 可降至 2 个,因重复性更好)。样本需 -80°C 保存,干冰运输。具体要求请参考送样指南。
典型鉴定深度和重复性?
DDA 模式典型鉴定 4000-6000 蛋白,DIA 模式可达 5000-8000 蛋白。DIA 定量 CV 通常 < 10%,优于 DDA 的 15-20%。DIA 的可重分析性极高,原始数据可反复挖掘新信息,适合长期纵向研究。
Labelfree 的批次效应如何控制?
Labelfree 每个样本独立运行,需要严格的实验设计控制批次效应:随机化上机顺序、插入 QC 质控样本、使用内标校正。DIA 模式因采集窗口固定,批次效应较 DDA 更低。MaxQuant 的 match between runs 功能可跨运行对齐定量,减少 missing values。