
DIA 定量蛋白组学概述
液相色谱联用串联质谱(LC-MS/MS)已经成为测量蛋白质、代谢物和脂质等生物分子不同状态的最有力工具。LC-MS 技术的应用已经从生物模型系统扩展到临床标本,包括组成和动态范围高度不同的体液和组织,在数百到数千个样品的大型项目中发挥着越来越重要的作用。[1]
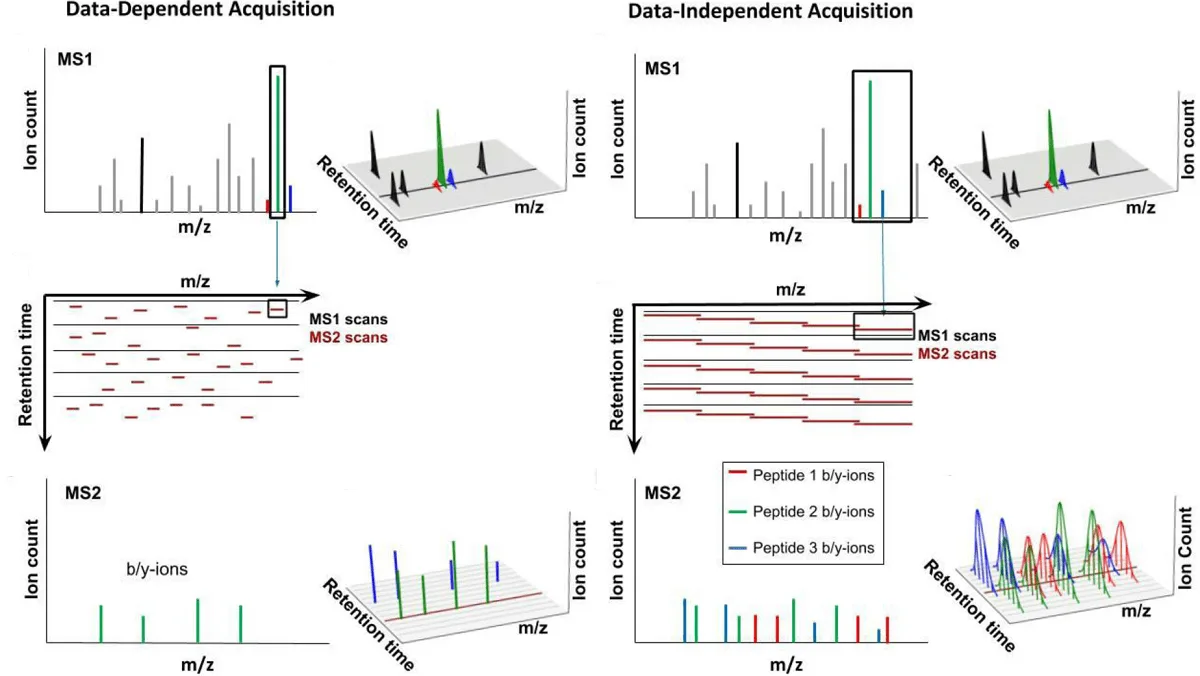
数据独立采集(Data Independent Acquisition, DIA)是串联质谱采集方案的一种,其核心特点是独立于前体离子的选择进行组成性碎裂。与基于数据依赖采集(DDA)的方法获取选定前体离子的 MS/MS 数据不同,DIA 技术在不偏向前体离子选择的情况下同时获取 MS1 和 MS2 数据,克服了 DDA 固有的不可重现性和欠采样的局限性。[2]
DIA 技术可以在隔离窗口内获取所有前驱体离子的 MS2 光谱,以获得全质量范围内完整的 MS/MS 数据,而无需事先了解前驱体信息。同时仍保持目标数据分析在准确性、再现性和一致性方面的可比特征,包括选择性反应监测(SRM)和平行反应监测(PRM)等目标方法的定量优势。[1]
DIA 定量蛋白组学的研究价值
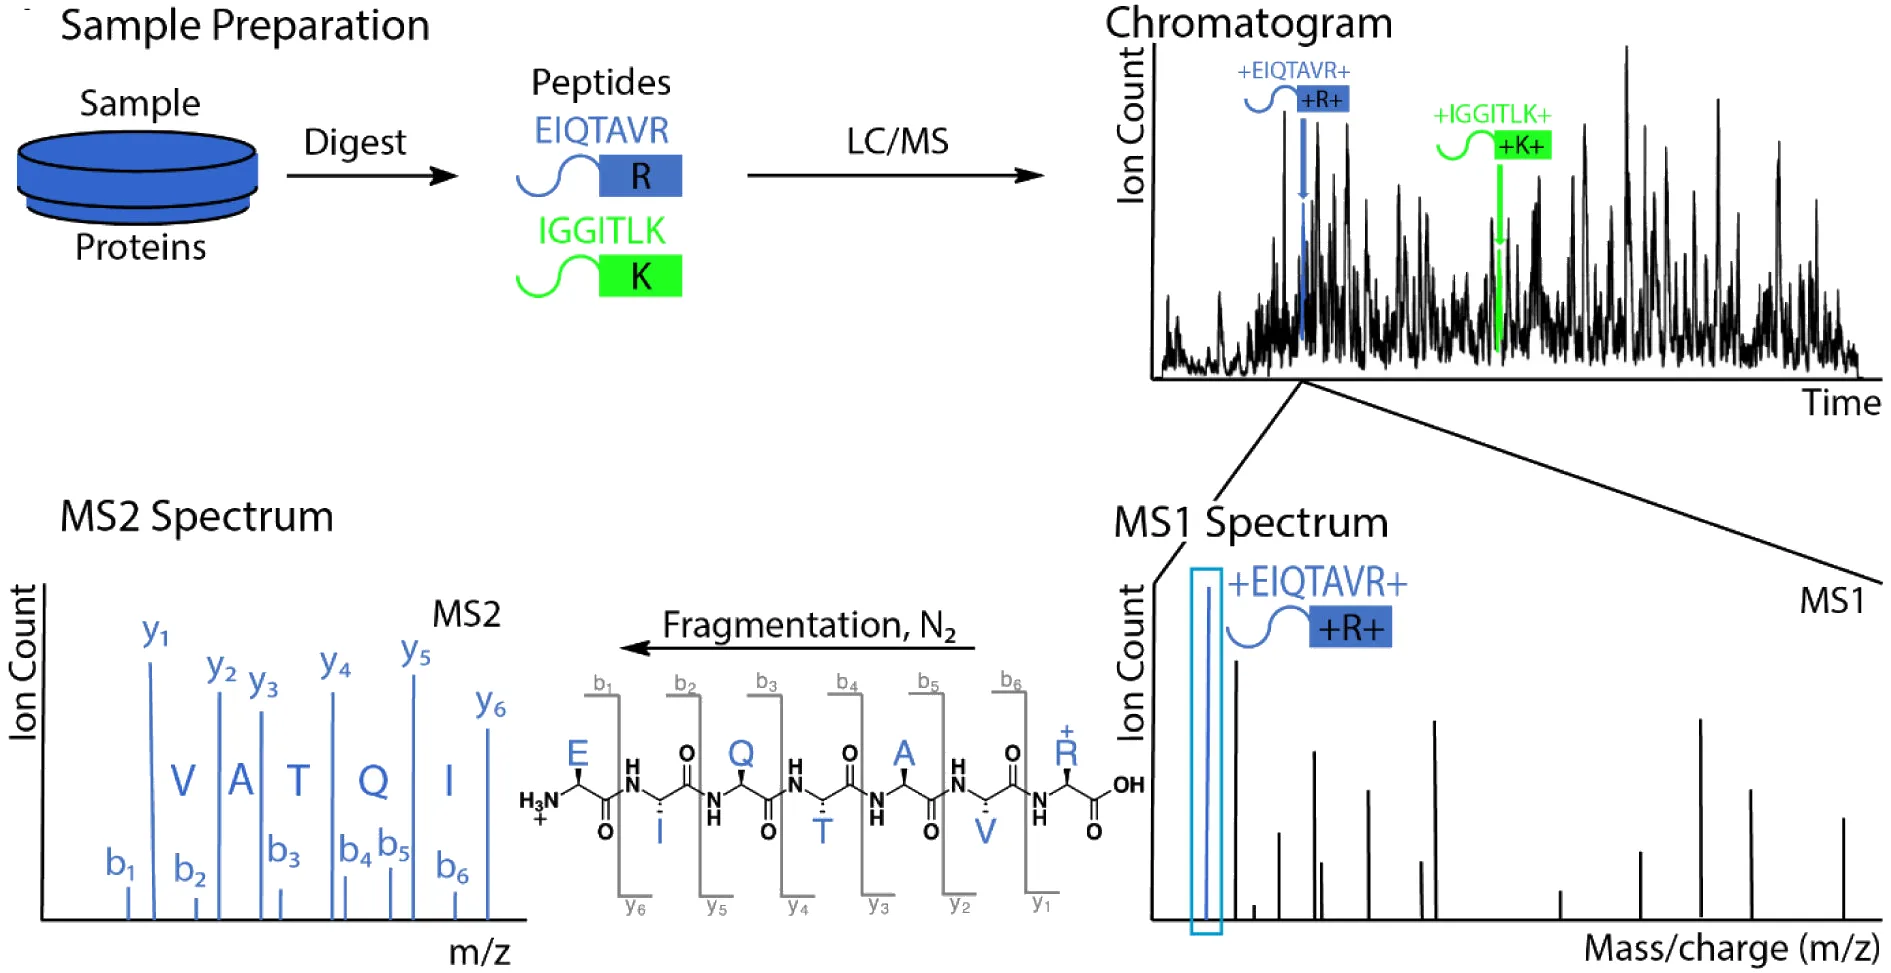
DIA 技术的最新进展提供了比传统数据依赖采集更高的灵敏度和蛋白质覆盖率。DIA 通过一组预先定义的肽前体隔离窗口循环,在整个液相色谱梯度中覆盖 400-1200 m/z 范围。所有的肽段都在一个隔离区内同时进行碎片化,并用串联质谱法进行检测。通过将质谱中的离子峰与包含肽片段离子模式及其色谱洗脱时间信息的谱库匹配来识别肽段。DIA 因其检测和定量能力的显著提升,在定量蛋白质组学领域越来越受欢迎。
疾病标志物筛选
DIA 特别适用于正常与疾病样本的比较分析,全质量范围无遗漏采集确保低丰度差异蛋白不被遗漏。在数百例临床大队列中,DIA 的批次重复性和定量一致性显著优于 DDA 方案,是精准医学和转化研究中蛋白质标志物筛选的首选技术。[3]
药物处理与时间序列分析
正常与药物处理样本比较、不同时间阶段比较等实验设计要求高度的定量重复性和跨批次一致性。DIA 无标记定量方案样本数量无上限,适合纵向追踪蛋白表达动态变化,为药物作用机制研究和药效评价提供可靠的蛋白水平证据。
修饰蛋白谱与大样本量筛选
DIA 可应用于修饰蛋白谱相关服务,在修饰肽段富集后进行全局定量分析。对于需要处理数百到数千个样本的大规模项目(如多中心临床队列、流行病学研究),DIA 无标记方案避免了标记试剂的高昂成本,同时保持优异的定量性能。[4]
Aimsmass 实验流程
Aimsmass 基于专业的 LC-MS/MS 质谱平台,提供高效、可靠的 DIA 定量蛋白组学服务,可对细胞、组织、血清及其他生物样本进行大规模差异蛋白筛选与表达分析。标准实验流程如下:
DIA 定量蛋白组学标准流程
样本前处理:适配细胞、组织、血清、微生物等多种样本类型,采用质谱兼容体系完成蛋白提取、还原烷基化、胰蛋白酶完整酶解,确保肽段质量和定量准确性。
纳流色谱分离:长梯度纳流反相色谱,有效分离复杂肽段混合物,减少离子抑制,提升低丰度肽段检出率。
DIA 质谱采集:通过一组预先定义的隔离窗口循环,在整个液相色谱梯度中覆盖 400-1200 m/z 全质量范围。所有肽段在隔离区内同步碎片化,无需前体离子预选,一次采集获取完整的 MS1 + MS2 数据。
专业生信解析:基于实测谱库或 in silico 预测谱库进行肽段匹配和蛋白鉴定,执行严格的 FDR 质控。MS1 峰面积归一化、批次校正后完成蛋白相对定量,输出差异蛋白列表及全套可视化图表。
DIA vs DDA vs iTRAQ/TMT 对比
| 对比维度 | DIA 无标记定量(主推) | DDA 无标记定量 | iTRAQ/TMT 标记定量 |
|---|---|---|---|
| 采集方式 | 全 m/z 窗口循环覆盖 | Top-N 高丰度优先 | 等重标记后 DDA |
| 低丰度蛋白 | 不遗漏,信号完整 | 大量丢失,欠采样 | 通量受限 |
| 缺失值 | 较 DDA 大幅降低 | 高缺失值 | 中等 |
| 定量重复性 | CV < 15%,批次一致 | 批次重复性差 | 受标记效率影响 |
| 样本通量 | 无上限,百例大队列可分批 | 可分批但重复性差 | 单次最多 8/16 个 |
| 标记成本 | 无标记试剂,成本最低 | 无标记试剂 | 高价标记试剂盒 |
| 数据可复用 | 无化学标签,后期可重新搜库回溯 | 可复用 | 受标记通道限制 |
| 推荐场景 | 大样本量临床队列、纵向追踪 | 小规模探索性研究 | 样本数 ≤16 的精确定量 |
数据分析
DIA 定量蛋白组学数据分析涵盖统计分析、功能注释分析和蛋白聚类与互作分析三大板块,全面展示蛋白表达差异和生物学功能信息。
统计分析
| 统计分析 | 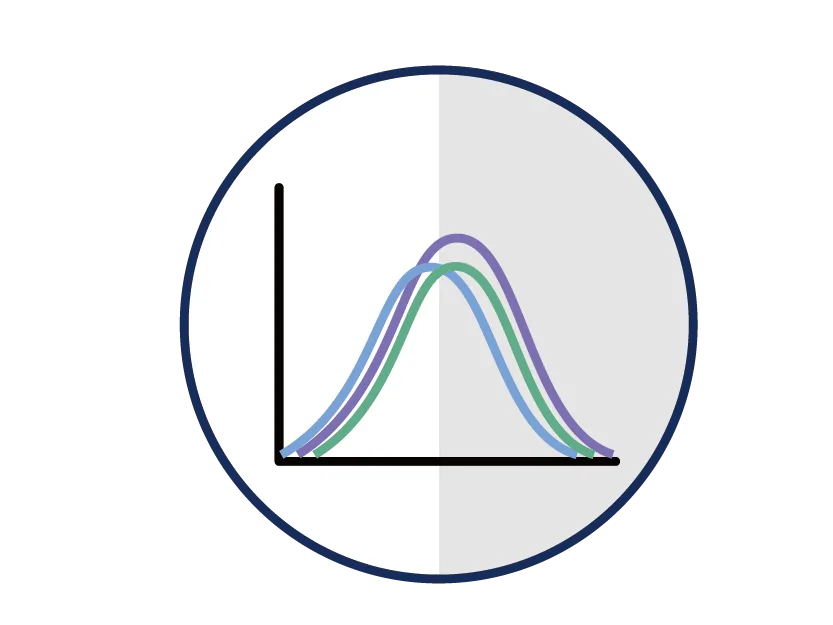 |
全局统计分析所有鉴定到蛋白表达量的分布范围,每条曲线表示一个样本,分布是经过正态分布拟合处理后的,图中纵坐标为频数,横坐标为表达量 log10 后的数值。 |
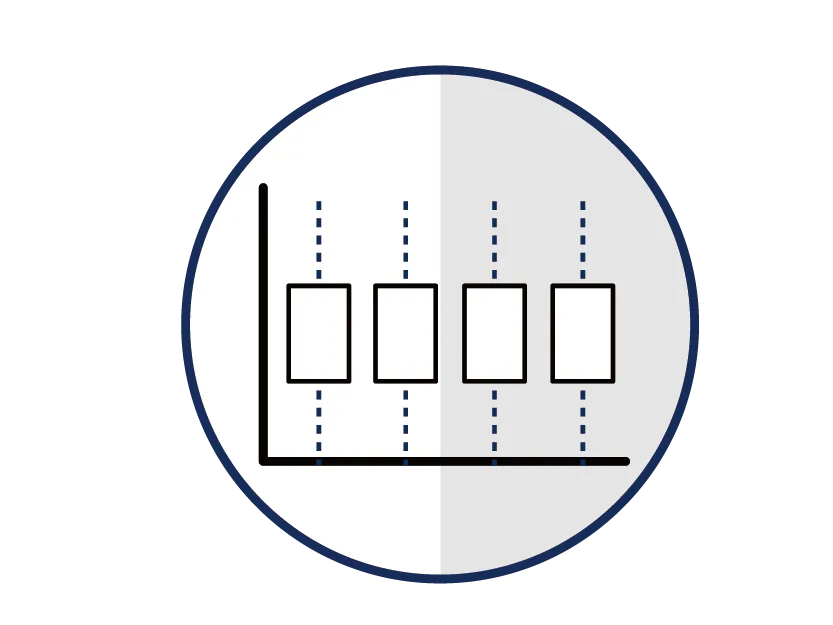 |
箱式图箱式图又称盒须图、盒式图或者箱线图,是一种表现有关数据的位置和分散情况资料的统计图。箱型图主要包含六个数据节点,可粗略表达出数据是否有对称性、分散程度等信息。 | |
 |
PCA 分析主成分分析(PCA 分析)是数理统计中的一种降维分析方法,将一组数据的主要矛盾提取出来,提取出的核心要素成为"成分"(component),并以百分比排序。排名靠前的主成分可以反应复杂数据中的关键信息。 | |
 |
火山图火山图(Volcano Plot)在一张图中显示了两个重要指标(Fold Change / p-Value),可以非常直观且合理地筛选出在样本之间发生差异表达的蛋白。 |
功能注释分析
| 功能注释 |  |
GO 注释基因的本体论(Gene Ontology)是建立一套特定的词汇集合来描述生物学功能,以此对基因功能注释统一化。用于描述生物学功能的词汇反映生物学功能的本质。 |
 |
KEGG 分析京都基因与基因组百科全书(KEGG)是基因组破译方面的数据库,整合了基因组、化学和系统功能信息的数据库,用于揭示差异蛋白参与的信号通路和代谢途径。 |
蛋白聚类与互作分析
| 聚类与互作 |  |
聚类热图聚类热图(heatmap)是通过排列矩阵的行列,将相似的数值放在一起展示聚类分析结果的图像,以直观呈现多样本多个蛋白的全局表达量变化,呈现多样本或多蛋白表达量的聚类关系。 |
 |
蛋白互作图蛋白互作图(PPI)预测蛋白之间相互作用的示意图,每一个圆形表示蛋白质,球之间的线条表示蛋白之间的相互关系。蛋白作为细胞功能执行者,不是凭借单个蛋白独立执行,而是依靠蛋白之间相互作用执行功能。 |
数据交付内容
蛋白定量总表
包含蛋白名称、蛋白编号、各样本中定量值、组间差异倍数(Fold Change)和统计显著性(p-Value)。
差异蛋白筛选结果
火山图、热图等差异分析图表,按 Fold Change 和 p-Value 双重阈值筛选的差异蛋白列表。
原始质谱数据
全部 LC-MS/MS 原始数据文件(.raw),支持后续独立分析与回溯挖掘。
功能注释与可视化图表
GO 注释、KEGG 通路富集、蛋白互作网络分析、聚类热图等可直接用于论文投稿的可视化图表。
送样要求
| 样本类型 | 送样量/每个样本 |
|---|---|
| 细胞系 | 1×10⁷ 个 |
| 动物组织(鸡肉/器官) | 50mg |
| 动物组织(骨骼/软骨) | 500mg |
| 植物组织(叶片/花) | 200mg |
| 植物组织(种子/根茎) | 5g |
| 血清/体液 | 500μL |
| 酵母/微生物 | 300-400mg |
| 蛋白溶液 | 250μg |
* 具体的样本制备和保存要求请参考送样指南,或联系技术支持获取定制化送样方案。
检测平台:Thermo Fisher Orbitrap Exploris 480 / Q Exactive HF-X 高分辨质谱仪(分辨率 240,000 @ m/z 200,扫描速度 40 Hz),搭配 EASY-nLC 1200 纳升液相色谱系统 + HPLC-MS/MS
开启您的 DIA 定量蛋白组学研究
提交咨询,Aimsmass 技术团队将根据您的课题定制 DIA 实验方案和报价。
获取定制方案与报价 查看全部定量蛋白组学服务相关蛋白质组学服务
参考文献
- Tian X, et al. Chemical isotope labeling for quantitative proteomics. Mass Spectrom Rev. 2021;42(2):546-576. DOI:10.1002/mas.21709 方法学,定量
- Sivanich MK, et al. Recent advances in isobaric labeling and applications in quantitative proteomics. PROTEOMICS. 2022;22(19-20):2100256. DOI:10.1002/pmic.202100256 综述,TMT
- Louca S, et al. Advances in data-independent acquisition mass spectrometry towards comprehensive digital proteome landscape. Mass Spectrom Rev. 2023;42(6):2324-2348. DOI:10.1002/mas.21781 DIA
- Li J, et al. Data-independent acquisition (DIA): an emerging proteomics technology for analysis of drug-metabolizing enzymes. Drug Discov Today Technol. 2021;39:49-56. DOI:10.1016/j.ddtec.2021.06.006 综述
常见问题
DIA 与 DDA 有什么区别?
DDA(数据依赖采集)仅筛选 Top-N 高丰度前体离子进行碎裂,低丰度肽段大量丢失,批次重复性差。DIA(数据独立采集)在不偏向前体离子选择的情况下,对全质量范围内的所有前体离子进行同步碎裂和 MS2 数据采集,克服了 DDA 固有的不可重现性和欠采样局限性,定量准确性和重复性显著优于 DDA。
DIA 适用于哪些研究场景?
DIA 特别适用于大样本量差异蛋白筛选,包括:正常与疾病样本比较、正常与药物处理样本比较、不同时间阶段比较、生物学重复比较等。也适用于修饰蛋白谱相关服务和临床大队列研究。Aimsmass 积累了丰富的相关服务经验。
DIA 送样要求是什么?
细胞系 1×10⁷ 个,动物组织(鸡肉/器官)50mg,动物组织(骨骼/软骨)500mg,植物组织(叶片/花)200mg,植物组织(种子/根茎)5g,血清/体液 500μL,酵母/微生物 300-400mg,蛋白溶液 250μg。具体要求请参考送样指南。
DIA 典型能鉴定多少个蛋白?
基于 Thermo Fisher Orbitrap Exploris 480 / Q Exactive HF-X 高分辨质谱平台,DIA 单次实验典型可鉴定 5000-8000 个蛋白,缺失值较 DDA 方案大幅降低,定量重复性 CV < 15%,技术重复相关系数优异。
项目周期多长?交付哪些内容?
标准交付周期约 3-4 周,从样本接收到数据报告交付。交付内容包括:原始质谱数据(.raw)、蛋白定量总表、差异蛋白筛选结果(火山图、热图等)、GO/KEGG 功能注释分析、蛋白互作网络分析、可直接用于投稿的可视化图表。如需生信深度分析可另行定制。
DIA 与 iTRAQ/TMT 标记定量有什么区别?
iTRAQ/TMT 是等重标记定量技术,需要化学标记试剂,单次实验样本数受限(iTRAQ 最多 8 标,TMT 最多 16 标)。DIA 为无标记定量技术,无需化学标记,样本数量无上限,适用于百例以上临床大队列研究,且避免了标记效率偏差带来的定量偏移。原始数据无化学标签修饰,后期可重新搜库回溯挖掘。